
目标:开发一款一键在多平台发布作品的桌面软件(Windows 安装器交付)。
非 AI 的总结
- 结论一:AI 大法好,但它更像“超强执行力的实习生”,不是能独立解决问题的技术专家。
- 结论二:vibe coding 的效率来自高频试错,而高频试错的代价是:不做工程纪律,你会被AI屎山埋掉。
- 结论三:真正决定产出质量的,不是“换更强模型”四个字,而是:
- 你的上下文管理能力(何时喂、喂什么、何时清)
- 你的工具编排能力(prompt,skill,回滚)
- 你的前后处理框架(需要把需求,问题,反馈,测试结构化)
上面三点,其实就是我在《2026 再谈 Manus》里总结的 Agent 应用三件套:前后处理框架 + 工具调用 + 上下文管理。这次我把它从“写在博客里很优雅”,变成了“踩坑时很狼狈”。
背景:我从一个半成品项目开始
在 GitHub 上找到一个半成品:
- 前后端架构都在
- 也有用于“发布作品”的 Playwright 脚本
- 但核心发布功能跑不通
- 前端按钮和后端逻辑有不少对不上(要么没接,要么没实现)
- 更要命的是:我对它的技术栈完全不懂
开发平台:Mac mini M4
工具:Claude Code CLI(下文简称 CC)+ glm-5
过程:五个阶段,29 小时,以及 2 亿 token 的“修行”
阶段一:初始化项目(1 小时)
一句话让 CC 完成:clone → 本地部署 → 启动前后端服务。
- 一次性成功
- 体验像“新手村教程”一样顺滑
这类阶段很适合 AI:目标明确、反馈清晰、路径依赖少。
阶段二:调试 Playwright 发布脚本(16 小时)
这一阶段是全篇的主角:最费时间、最费 token、最不“vibe”。
测试后发现:除了视频号,其他平台脚本几乎全挂。
抖音:二次选择封面 + 确认
问题点并不复杂:
- 发布流程里多了一个二次选封面步骤
- 需要额外确认
困难在于:CC 不能“像人一样”理解 Playwright 打开的 Chrome 页面实际发生了什么。
我尝试过:
- 手动描述脚本执行过程 + 卡点,让 CC 推理改脚本
- 用 Playwright 调试器
- 用 Playwright recorder 录制“我手动选封面”的过程,想让 CC 仿照录制结果改脚本
结局:都失败。
最后我在 GitHub issue 里找到了别人踩过的坑和解决方案。
这一刻你会意识到:AI 很会写代码,但它并不总能“看见世界”。而自动化脚本的问题,本质上是UI 与状态机问题——它需要观测,需要证据链。
小红书:提前启动文件选择器 → CC 修复失败 → 原来是 config
观察现象:进入发布页后,脚本过早拉起文件选择器,导致状态错位。
我让 CC 修:失败。
最后靠古法编程(人类的眼睛 + 耐心 + 读配置):发现是 config 写错,手动改正后通过。
快手:首次进入弹“新手教程”→ 选择器失效
首次进入发布页会弹出教程浮层,直接破坏页面布局与选择器假设。
- 手动叉掉教程后可正常执行
- 更工程化的解决方式,是加检测逻辑:识别浮层 → 关闭 → 继续
阶段二的复盘:为什么浪费了 5000w token 但没解决“核心问题”
因为我把它当成了“写代码问题”,但它其实是:
- 工具调用的可观测性不足:没有足够截图、trace、日志,把 UI 状态变成可推理的数据
- 上下文沟通损耗极高:我在用人类语言描述 UI,AI 在用 token 猜 UI
- 问题边界不断漂移:从 selector 到 timing,从 timing 到 config,从 config 到 onboarding 浮层
这就是《2026 再谈 Manus》里那句很朴素但很狠的话:
基座模型决定上限,而下限往往由外围工程保障。
Playwright 脚本的下限,靠的不是“更聪明的句子”,而是“更可靠的证据”。
阶段三:打包为 Mac 桌面端(2 小时)
和 CC 讨论后选了 Electron,目标是打包成标准 .dmg 安装器。
我的分工很明确:
- CC 主导工程改动
- 我只做测试 + 反馈 bug
2-3 次尝试后打包成功。
但打包后出现:
- 某些功能和开发环境表现不一致
我吸取了阶段一的经验,直接要求:
- 增加开发者平台调试支持(可定位、可复现、可回滚)
然后很快修正。
阶段四:跨平台打包 Windows(4 小时)
这部分的核心不是技术,而是生态差异:
- 系统架构变了
- CC 在 PowerShell 环境水土不服
- 命令执行失败率上升
- 需要多轮尝试探索“正确的 ps 咒语”
- Windows 初始没装 Chrome
- CC 打包时没做依赖检测与提示
- 导致发布流程启动直接失败
这段让我更确信:AI 很擅长“解决局部问题”,但不擅长自动补齐工程边界。工程边界需要人来定义。
阶段五:测试与修复(6 小时)
Windows 上实测发现大量 bug。
最核心的一次改动:实现“发布失败后点击按钮直接重试”的逻辑。
坑点链条如下:
- CC 只改了后端逻辑
- 但没更新数据库 schema / 数据
- 后端逻辑依赖的字段在数据库里不存在 → 运行时爆炸
更坑爹的是:
- CC 打包时把开发环境数据库错误指向了桌面软件的数据库路径
- 导致我看到的路径和实际使用的路径不一致
- 于是即使 git 回滚到上一个可行版本,软件仍然跑不起来
在多轮 battle 后,我定位到这个问题:
- 手动删除多余的数据库创建脚本
- 删除多余的数据库文件
此外还有一些“看似小、但很真实”的坑:
- 素材库命名为中文 → 发布时路径拼装错误
最终迭代到 1.1.0 后核心功能基本稳定,但细节仍多;继续迭代到 1.2.1 后交付测试。
结果:29 小时 + 2 周夜间时间 + 2 亿 token ≈ 200 元
- 合计开发时间:29 小时
- 实际历时:2 周(下班后进行)
- token 消耗:约 2 亿
- 成本:中途升级了 coding plan,折算约 200 元
最终交付:Windows 安装器
- 核心功能:多平台一键发布 ✅
- 用户体验:可用,但仍有很多细节待优化
限制来源也很现实:
- 系统 bug:例如中文路径支持
- 平台限制:
- 抖音首次发布需要验证码
- 快手首次进入弹教程
这些都能通过检测逻辑和流程分支逐步工程化,但意味着更长时间投入。
经验:vibe coding 的三条“反直觉”工程纪律
1) 用 git,而且要用到“像呼吸一样频繁”
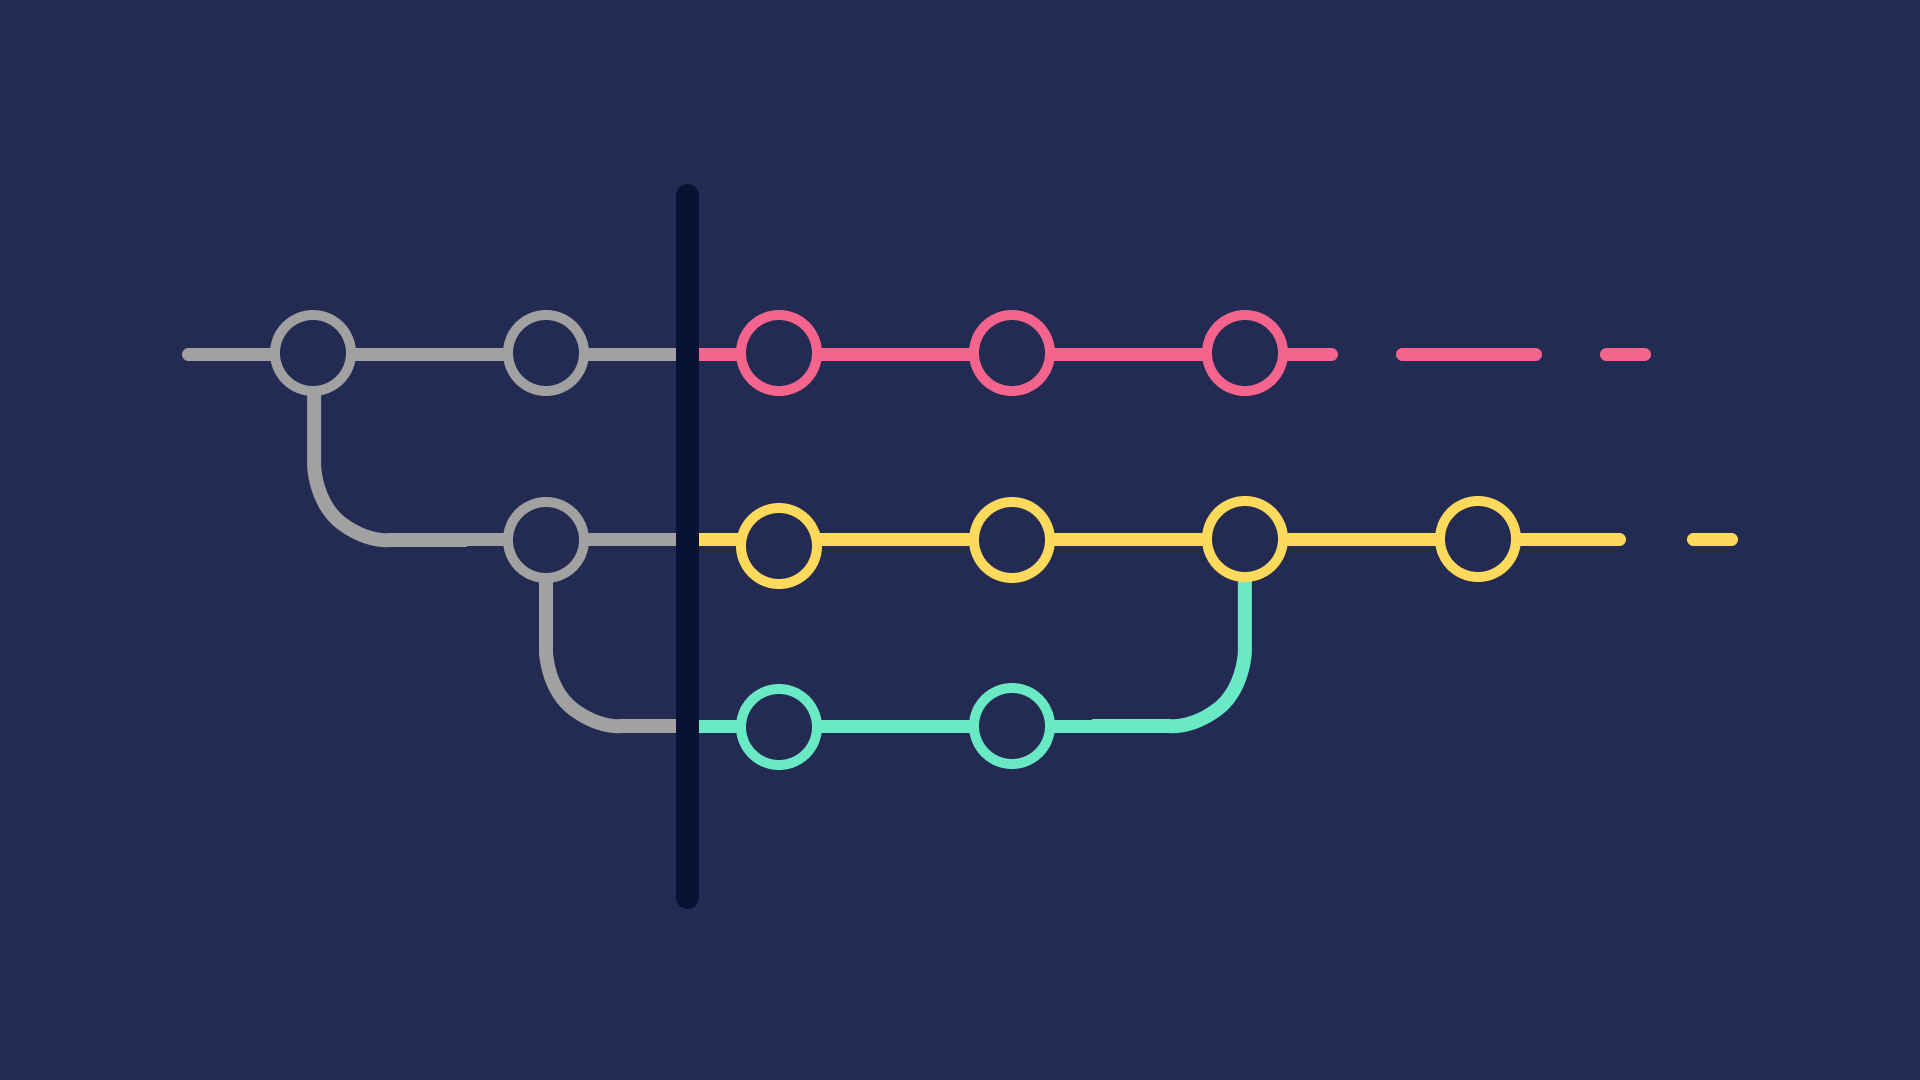
vibe coding 的节奏是:
- feature 小
- 迭代快
- 改动密
于是你必须:每做完一个小 feature 并验证,就 commit 一次。
否则 AI 很容易把代码改坏,你会迷失在数百个 diff 里:
- 分不清哪是新 bug
- 分不清哪是修 bug 的副作用
- 更分不清哪是“AI 顺手重构了一整个无关模块”
2) 及时 clear context:上下文不是越长越强,而是越长越“偏航”
我在打包阶段发现:
- CC 遇到问题后,如果不 reset,上下文会把它锁死在一条错误路线
- 它会持续“合理化”之前的错误假设
- 然后产出一连串看似努力、实则徒劳的修复
及时清上下文,反而更像“让它重新开机”,成功率显著提升。
这就是 Agent 的“上下文管理”——不是记忆越多越好,而是目标对齐越强越好。
3) 用好 Harness engineering:别裸奔,让 AI 在护栏里跑
前期我用裸奔 CC:
- 成功率低
- 经常乱改代码
- 修复 A 的同时顺手改坏 C
后期我开始套用一些成熟的 rule / skill(可以理解为护栏与流程):
- 输出更稳定
- 改动更精准
- 更像“按图施工”,而不是“灵感创作”
如果把 AI 当工程伙伴,你必须给它工程化的工作方式。
总结:AI 会取代程序员吗?大概率不会,但会把门槛拉高
这次实战让我对“AI 代替程序员”的观点更冷静:
- 它不会完全代替
- 但它会显著降低“写代码”这件事的稀缺性
- 对程序员的需求不一定下降,但对程序员的要求会变
未来更值钱的能力,可能是:
- 定义问题边界
- 搭建可观测性
- 设计护栏与流程
- 管理上下文与目标对齐
也就是:成为一个好的 AI 驾驭者。
最后留一句很不严谨但很真实的感受:
AI 大法好,但也没那么好。你以为它在帮你写代码,其实它在逼你学工程。